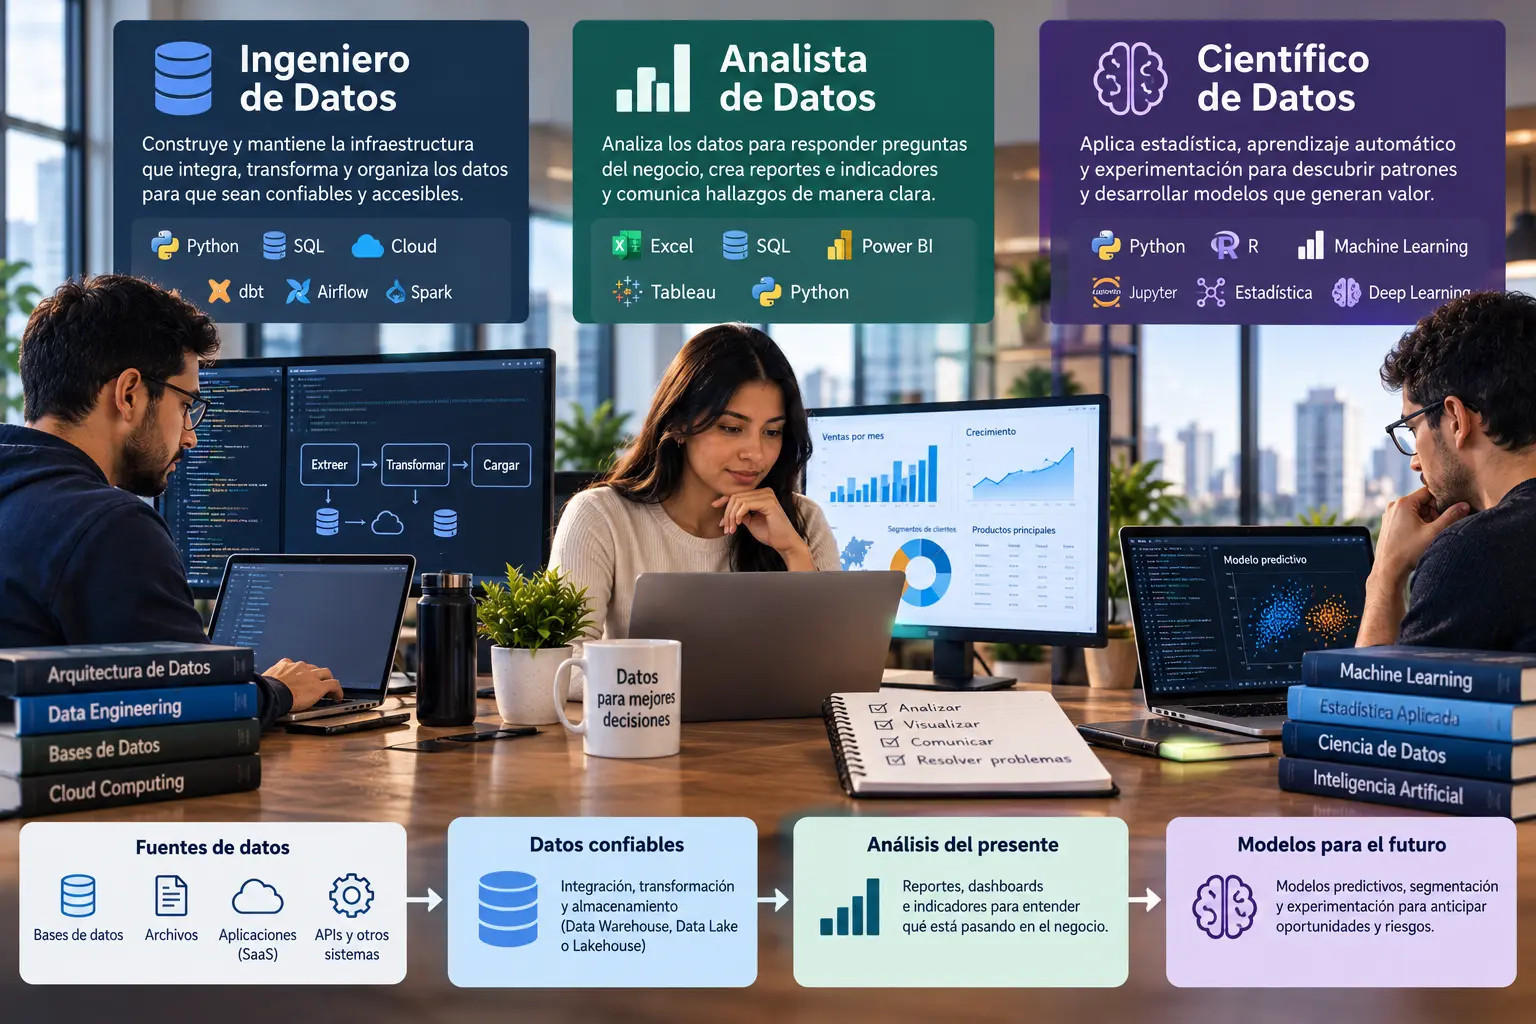
El ingeniero de datos construye y mantiene sistemas que hacen los datos confiables y accesibles; el analista los utiliza para comprender el negocio y apoyar decisiones; y el científico de datos aplica estadística y métodos computacionales para investigar patrones, desarrollar modelos y resolver problemas analíticos más complejos.
Son especializaciones complementarias con habilidades que se superponen, no categorías rígidas ni escalones obligatorios. El título y el alcance cambian según la empresa: una misma persona puede asumir responsabilidades de más de un rol.
¿Cuál es la diferencia entre un analista, un ingeniero y un científico de datos?
La diferencia principal está en el propósito del trabajo, el problema que se intenta resolver y el entregable esperado. Esta tabla resume responsabilidades típicas, no fronteras universales.
| Profesión | Responsabilidad principal | Preguntas que responde | Entregables habituales | Conocimientos principales |
|---|---|---|---|---|
| Analista de datos | Convertir datos en información útil para comprender el negocio y decidir. | ¿Qué ocurrió, por qué y dónde actuar? | Análisis ad hoc, KPIs, reportes, dashboards y recomendaciones. | Negocio, SQL, visualización, modelado, estadística y comunicación. |
| Ingeniero de datos | Diseñar y operar sistemas que integran, transforman y entregan datos confiables. | ¿Cómo mover, organizar y servir datos con calidad y confiabilidad? | Pipelines, modelos de datos, plataformas, controles y documentación. | Bases de datos, programación, arquitectura, nube, calidad y operación. |
| Científico de datos | Aplicar estadística y métodos computacionales para investigar y desarrollar soluciones analíticas. | ¿Qué patrón existe, qué puede estimarse y cómo evaluar una intervención o modelo? | Experimentos, modelos, segmentaciones, pronósticos y evaluaciones. | Probabilidad, estadística, programación, ML, experimentación y dominio. |
¿Qué hace un analista de datos?
Un analista comienza por comprender una necesidad: por qué bajaron las ventas, qué productos son más rentables, cuáles sucursales rinden por debajo de lo esperado o cómo cambian los indicadores. Identifica información relevante, consulta con SQL u otras herramientas, perfila su calidad, limpia y transforma datos, define métricas, explora patrones y comunica resultados.
El trabajo no se limita a consumir tablas preparadas. Según la organización, puede combinar fuentes, crear modelos de datos o semánticos y mantener una solución de reporting. Microsoft Learn incluye entre las responsabilidades del analista perfilar, limpiar, transformar y modelar datos, además de visualizar, reportar y trabajar con stakeholders. Es una descripción formativa de Microsoft, no una regla que obligue a cada analista a usar sus productos.
Análisis ad hoc
Responde una pregunta específica o investiga una situación. Por ejemplo, compara ventas por canal, revisa si el descenso se concentra en una categoría y contrasta el patrón con inventario, precios y promociones. El resultado puede ser una explicación breve con evidencia y próximos pasos.
Reporting recurrente
Crea una solución que se actualiza periódicamente para monitorear el negocio: indicadores definidos, controles de calidad, visualizaciones, filtros y documentación. Un dashboard no sustituye el razonamiento; organiza información para que las personas detecten cambios y profundicen.
Excel, SQL y Power BI son opciones frecuentes, junto con Tableau, Python y otras tecnologías. El marco de la certificación PL-300 de Microsoft, específico de Power BI, cubre preparación, modelado, visualización, análisis, administración y seguridad. Sirve como ejemplo de amplitud, no como definición universal del oficio.
¿Qué hace un ingeniero de datos?
Diseña y mantiene el recorrido que convierte datos de sistemas operacionales en información disponible y confiable. Puede trabajar con bases transaccionales, APIs, archivos, aplicaciones SaaS, eventos en tiempo real y otras fuentes.
- Identifica fuentes, propietarios, formatos y requisitos.
- Ingiere o extrae datos por lotes o mediante streaming.
- Transforma, estandariza e integra información.
- Valida calidad, completitud y consistencia.
- Almacena y organiza según el uso previsto.
- Modela datos para análisis, aplicaciones u otros consumidores.
- Orquesta, observa y mantiene pipelines.
- Gestiona rendimiento, confiabilidad, seguridad y gobierno.
En ETL, los datos se extraen, se transforman y luego se cargan al destino. En ELT, se extraen y cargan primero, y las transformaciones se ejecutan dentro de la plataforma de destino. La elección depende de arquitectura, controles, volumen, latencia y herramientas; ninguna sigla garantiza por sí sola una buena solución.
¿Qué es un data warehouse?
Es un repositorio diseñado para cargas analíticas: integra datos de distintas fuentes y los organiza para consultar tendencias, comparar periodos y calcular indicadores con eficiencia. Una base transaccional prioriza registrar operaciones como pedidos o pagos de forma consistente; un warehouse prioriza analizar grandes conjuntos y relacionar hechos históricos. No es simplemente “una base con muchos datos”.
¿Qué es el modelado dimensional de Kimball?
El enfoque parte del proceso de negocio y define el grano: qué representa exactamente cada fila. Luego separa los eventos medibles en tablas de hechos y su contexto descriptivo en dimensiones. La documentación del Kimball Group presenta proceso, grano, hechos y dimensiones como conceptos fundamentales.
Una tabla de hechos puede guardar cada línea de venta con cantidad, precio y descuento. Las dimensiones Fecha, Producto, Cliente y Tienda describen cuándo, qué, quién y dónde. En un esquema estrella, la tabla de hechos se conecta directamente con esas dimensiones, como explica la referencia de esquemas estrella de Kimball.
Este modelo facilita ciertos patrones analíticos, pero no todos los sistemas deben usarlo. El diseño correcto depende del caso de uso.
¿Todos los ingenieros de datos trabajan con data warehouses?
No. También pueden construir data lakes, plataformas de eventos, servicios de integración o lakehouses. Un data lake conserva datos diversos con mayor flexibilidad; un lakehouse busca combinar ese almacenamiento con estructura y funciones de gestión propias de un warehouse, según la definición técnica de Google Cloud. Es una fuente de proveedor, por lo que aquí se usa solo para el concepto general.
La arquitectura depende de tipos de datos, escala, latencia, seguridad, gobierno y cargas posteriores. Un pipeline tampoco tiene que terminar siempre en un warehouse.
¿Qué hace un científico de datos?
Aplica análisis estadístico, programación, inferencia, experimentación y aprendizaje automático para investigar fenómenos y construir soluciones. El campo incluye regresión, clasificación, clustering, detección de anomalías, segmentación, pronósticos y evaluación de modelos. No se reduce a predecir el futuro ni es sinónimo de inteligencia artificial generativa.
IBM define la ciencia de datos como una combinación de matemáticas, estadística, programación, analítica, machine learning y conocimiento del dominio. Es una visión amplia de proveedor que respalda el carácter multidisciplinario, no una lista obligatoria para cada puesto.
Ejemplos de problemas
- Abandono de clientes: estimar la probabilidad de que una persona deje de usar un servicio.
- Propensión de compra: estimar la probabilidad de que un prospecto compre bajo ciertas condiciones.
- Pronóstico de demanda: estimar valores futuros a partir de patrones históricos y variables relevantes.
- Clasificación de imágenes: determinar si una imagen contiene una persona u otra categoría. Esto clasifica una observación; no necesariamente predice un evento futuro.
También puede comprobar hipótesis, diseñar experimentos y evaluar si un modelo generaliza. Una métrica alta en entrenamiento no basta: importan la calidad de datos, el método de evaluación, los costos de error, los sesgos y la utilidad operacional.
¿Dónde se utilizan los modelos?
Los modelos pueden integrarse en aplicaciones, APIs, flujos operativos, pipelines por lotes, plataformas analíticas o sistemas de apoyo a decisiones. No tienen que ejecutarse dentro de un data warehouse. Su despliegue y mantenimiento puede involucrar científicos de datos, ingenieros de machine learning, software y datos, según el equipo y la solución.
Ejemplo práctico: los tres profesionales trabajando en la misma empresa
Escenario hipotético: una empresa minorista vende en una tienda virtual y otra física. Mantiene clientes, productos y transacciones en varios sistemas. Quiere comprender su rendimiento y mejorar la retención.
El ingeniero integra las fuentes, estandariza identificadores y fechas, valida reglas y publica conjuntos confiables; podría implementar un modelo dimensional u otra arquitectura apropiada. El analista investiga qué productos venden más, dónde caen las ventas, cómo evoluciona el ingreso mensual y qué segmentos aportan más. Puede convertir ese seguimiento en reportes o dashboards.
El científico usa datos pertinentes para desarrollar y evaluar, por ejemplo, un modelo de abandono o propensión de compra. Sus resultados podrían ayudar a priorizar una acción, pero el equipo debe comprobar su calidad y definir cómo intervenir. Los roles colaboran, pero no forman una cadena obligatoria: no todas las empresas necesitan los tres ni ciencia de datos tiene que esperar a que exista un dashboard.
Herramientas que utilizan: ¿cuáles comparten y cuáles son diferentes?
| Rol | Herramientas y tecnologías posibles | Para qué pueden utilizarlas |
|---|---|---|
| Analista | Excel, SQL, Power BI, Tableau, Python | Preparación, consulta, exploración, métricas, visualización y comunicación. |
| Ingeniero | SQL, Python, dbt, Apache Airflow, Apache Spark, nubes, warehouses y lakehouses | Integración, transformación, modelado, orquestación, rendimiento y operación. |
| Científico | Python, R, SQL, pandas, scikit-learn, librerías estadísticas y frameworks de ML | Exploración, inferencia, experimentos, entrenamiento y evaluación de modelos. |
Son ejemplos, no paquetes obligatorios. SQL puede servir al analista para responder una pregunta, al ingeniero para transformar y modelar datos y al científico para construir una muestra. Python puede automatizar un análisis, operar un pipeline o entrenar un modelo. La tecnología no define por sí sola la profesión.
¿Qué conocimientos necesita cada profesional?
Analista de datos
Procesos de negocio, análisis, SQL, visualización, modelado de datos, estadística básica y comunicación. En puestos especializados puede necesitar métodos cuantitativos más avanzados.
Ingeniero de datos
Bases de datos, programación, arquitectura, modelado, pipelines, orquestación, calidad, infraestructura de nube, seguridad y confiabilidad.
Científico de datos
Probabilidad, estadística, programación, machine learning, experimentación, evaluación de modelos y conocimiento del dominio. También puede crear análisis descriptivos, reportes y visualizaciones cuando el problema lo exige.
La profundidad cambia con el sector, la posición y la seniority. En los tres caminos conviene aprender a formular preguntas, verificar resultados y explicar límites.
¿Cuál carrera deberías elegir?
Considera análisis de datos si disfrutas
Comprender problemas de negocio, hacer preguntas, encontrar patrones, trabajar con stakeholders, construir reportes o dashboards y explicar resultados.
Considera ingeniería de datos si disfrutas
Construir sistemas, programar, trabajar con bases de datos, automatizar, diseñar arquitectura y resolver problemas de confiabilidad e infraestructura.
Considera ciencia de datos si disfrutas
La estadística, el razonamiento matemático, la experimentación, los modelos predictivos, machine learning y problemas con un componente de investigación.
Estas son tendencias, no una prueba de personalidad. Puedes disfrutar más de un campo, y una práctica pequeña en cada uno ofrece mejor evidencia que elegir solo por el título. Si buscas tu primera oportunidad, consulta también la guía para prepararte y demostrar habilidades en análisis de datos.
¿Debo comenzar como analista para convertirme en ingeniero o científico de datos?
No. Empezar en análisis puede ser una forma práctica de familiarizarse con datos, SQL y problemas de negocio, y después complementar programación, arquitectura, matemáticas o machine learning. Pero ingeniería y ciencia de datos tienen fundamentos adicionales que también pueden aprenderse directamente por otras rutas académicas y profesionales.
Pasar de un campo a otro exige aprendizaje y experiencia; no es un ascenso automático. Para construir una base analítica puedes revisar el roadmap para comenzar como analista de datos y los cursos de Excel, SQL y Power BI para análisis. Esos fundamentos no sustituyen la formación adicional necesaria para ingeniería o ciencia de datos.
La inteligencia artificial también cambia tareas en los tres campos. La guía sobre IA y el futuro del analista de datos explica por qué automatizar una tarea no equivale necesariamente a eliminar una profesión.
Preguntas frecuentes
¿Qué diferencia hay entre analista de datos y científico de datos?
El analista suele enfocarse en comprender el desempeño y apoyar decisiones; el científico aplica con mayor frecuencia estadística, experimentación y machine learning para investigar y modelar problemas. Hay tareas compartidas y los límites varían.
¿Un ingeniero de datos necesita saber SQL?
SQL es muy útil y frecuente para consultar, transformar y modelar datos relacionales, aunque la profundidad y otras tecnologías dependen de la arquitectura y el puesto.
¿Un analista de datos necesita saber Python?
No en todos los puestos. Python amplía opciones de automatización y análisis, pero algunos roles se desarrollan principalmente con SQL, hojas de cálculo y plataformas de BI.
¿Un científico de datos también utiliza SQL?
Sí, puede usarlo para localizar, combinar y preparar información. También puede trabajar con archivos, APIs, datos no estructurados y otras interfaces.
¿Cuál de las tres carreras requiere más matemáticas?
Ciencia de datos suele exigir mayor profundidad en probabilidad, estadística y álgebra para modelar y evaluar. Sin embargo, el nivel real varía y los tres roles usan razonamiento cuantitativo.
¿Cuál es mejor para alguien que está comenzando?
Depende de sus intereses y fundamentos. Análisis ofrece una entrada práctica a preguntas de negocio, pero no es un requisito previo para las otras rutas.
¿Puedo pasar de análisis de datos a ingeniería de datos?
Sí, desarrollando programación, bases de datos, arquitectura, pipelines, nube y operación. La transición requiere aprendizaje deliberado y experiencia, no ocurre automáticamente.
¿Las tres profesiones utilizan inteligencia artificial?
Pueden utilizarla para asistir código, documentación, análisis o modelos, pero no todos los puestos lo hacen ni ciencia de datos equivale completamente a IA.
¿Quieres comenzar una carrera en el mundo de los datos?
Aprende fundamentos prácticos de análisis de datos con Excel, SQL y Power BI y desarrolla habilidades para comprender información y resolver problemas de negocio.
Explorar cursos de WILLDUET AcademyFuentes y alcance
- Microsoft Learn: Training for Data Analysts.
- Microsoft Learn: Study guide for Exam PL-300.
- Kimball Group: Dimensional Modeling Techniques y Star Schemas and OLAP Cubes.
- Google Cloud: What is a Data Lakehouse?.
- IBM: What is Data Science?.
Las responsabilidades y tecnologías son ejemplos típicos, no requisitos universales. Las fuentes de proveedores se usan para definiciones técnicas concretas; no respaldan afirmaciones de salario, demanda laboral ni resultados garantizados.